事例2:ソースコードからDB定義書を最新化する
課題:DB定義書への転記作業が「後で」に回され続ける
models.py にはコメントと型定義が揃っている。でもDB定義書は物理名が並んだまま──200カラム分の論理名を確認・転記する2時間は、いつも「後で」に回されてしまう。
TRACERY MCPを使うと、この転記作業をAIエージェントに任せられます。
結果:2時間の転記作業が15分に
従来(手作業) |
MCP活用 |
|
|---|---|---|
作業時間 |
約2時間 |
約15分(87%削減) |
内訳 |
コード確認30分、論理名検討30分、転記60分 |
AIが解析・更新10分、人間の確認・承認5分 |
テーブル数12・約200カラムの実プロジェクトでの実測値です。
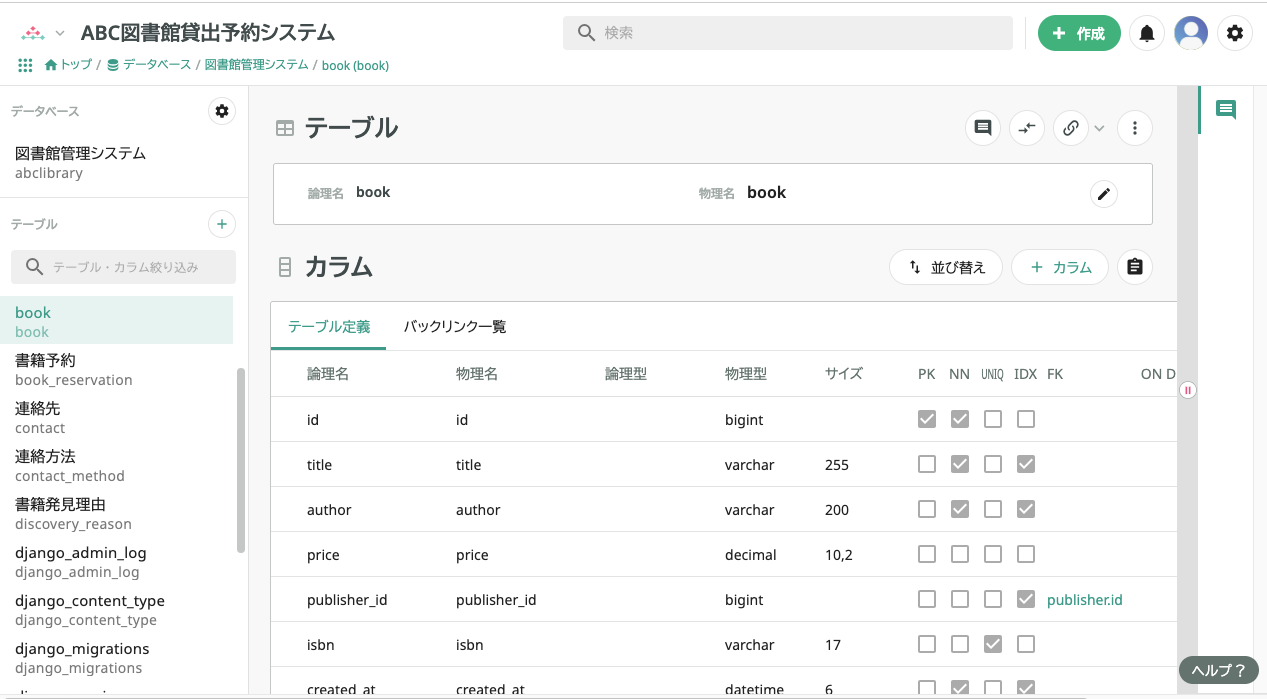
Before:物理名だけが並ぶDB定義書
After:論理名と説明が埋まったDB定義書
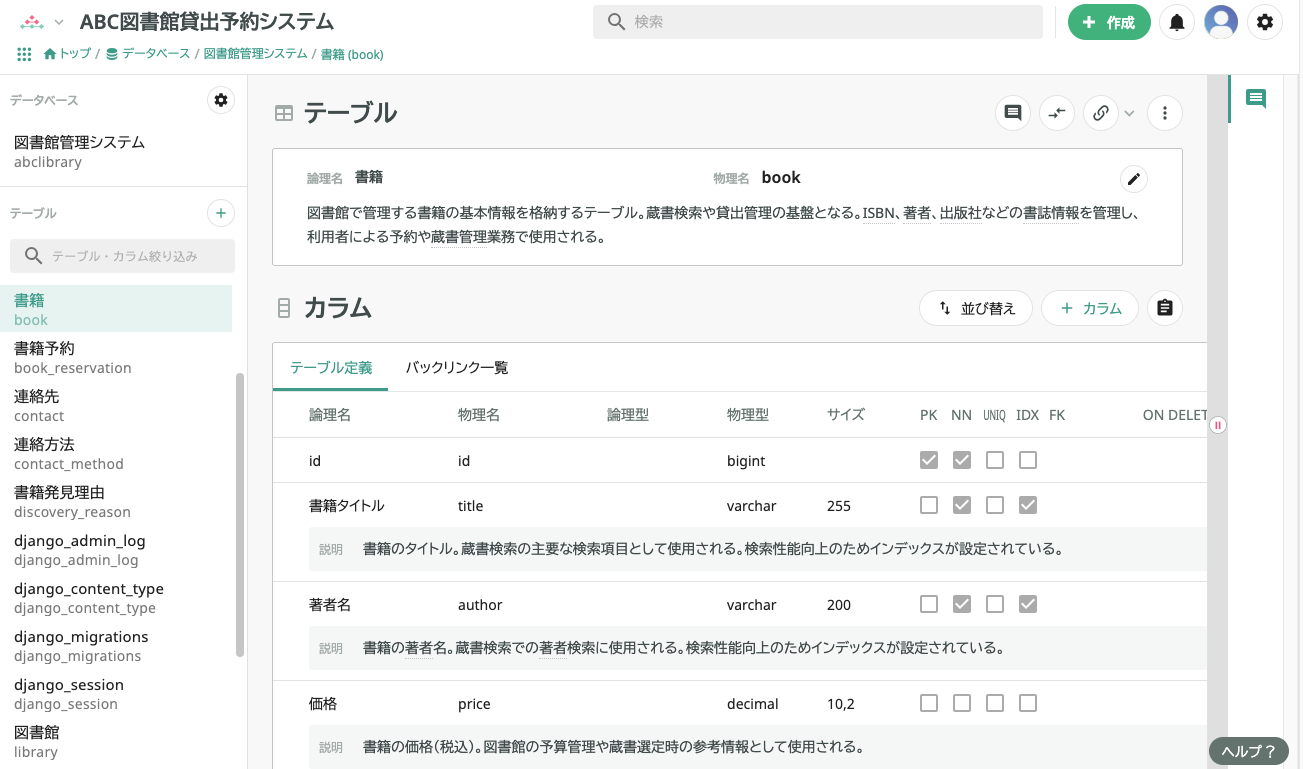
AIが設定する内容のイメージ:
カラム |
Before |
After(AIが設定した論理名・概要) |
|---|---|---|
|
(物理名のまま) |
出版年月日/蔵書検索での出版年絞り込みに使用される日付 |
|
(物理名のまま) |
ISBN/UNIQUE制約:同一書籍の重複登録を防ぐため |
やっていること
AIエージェントがソースコードを解析し、TRACERY MCPを通じてDB定義書に論理名・説明を書き込みます。人間の役割は指示と確認・承認だけです。
        %%{init: {"theme": "neutral"}}%%
flowchart LR
    Src[ソースコード<br>models.py] --> Agent[AIエージェント]
    Agent -->|論理名・説明を書き込み| MCP[TRACERY MCP] --> DB[DB定義書]
    User((利用者)) -->|指示| Agent
    Agent -->|承認依頼| User
実際の手順
1. 物理定義を一括インポートしておく
テーブル・カラムの物理定義はMCP経由でも登録できますが、件数が多い場合はTRACERYのデータベース管理機能へのSQLインポートでDDLから一括登録しておくと効率的です。論理名・説明などDDLに現れない情報を、次のステップでAIに補完させます。
2. AIエージェントに指示する
プロンプト例
#tracery でDB定義を確認してください。
models.py の内容を元に、テーブルやカラムの論理名をDB定義に設定してください。
- DB定義にコメント(説明、概要)も設定してください。
- 概要には、論理名を元にどのような用途なのか追加情報を記載してください。
- 概要はidやFKなど明確なものには不要ですが、説明が必要であれば設定してください。
- INDEXやUNIQUEなどの制約を付けた理由を伝える必要があれば、概要に追記してください。
3. AIの提案を確認して承認する
AIエージェントが #update_column などのツール実行を提案してきます。変更内容を確認して承認してください。
AI応答例(イメージ)
models.py を解析しました。Book モデルの8カラムについて、以下の論理名・概要を設定します(抜粋)。
publish_date→ 論理名「出版年月日」、概要「蔵書検索での出版年絞り込みに使用される日付」isbn→ 論理名「ISBN」、概要「UNIQUE制約:同一書籍の重複登録を防ぐため」
#update_column を実行してよろしいですか?
4. TRACERYの画面で結果を確認する
AIの出力は推論に基づくため、誤りを含む可能性があります。DB定義書上で内容を確認し、必要に応じて修正してください。
コツと注意点
ドメイン知識が要る箇所は人間が直す前提で。命名規則やコメントから推論できる論理名の精度は高いですが、業務固有の意味づけは確認が必要です。
制約を付けた理由も書かせると、後からDB定義書を読む人(と次のタスクのAI)への価値が上がります。
ここで整備したDB定義書は、事例3:API設計・実装などの後続タスクでAIが参照するコンテキストになります。
開発サイクルでの位置づけ
        %%{init: {"theme": "neutral"}}%%
flowchart LR
    A[事例1:用語集の整備] --> C[事例3:API設計・実装]
    B[事例2:DB定義書の最新化]:::current --> C
    C --> D[事例4:運用手順書の整備]
    D -.->|知見の還流| A
    D -.-> B
    classDef current fill:#4a6fa5,color:#fff,stroke:#4a6fa5
項目 |
内容 |
|---|---|
受け取るもの |
実装済みのソースコード(モデル定義・コメント・制約)。事例1で整備した用語集があれば、論理名の命名もチームの用語に揃う |
この事例で作る資産 |
論理名・説明・制約を付けた理由まで記録されたDB定義書 |
次の事例への効き方 |
事例3のAPI設計でAIがDB定義を前提知識として参照するため、実在しないカラムを使った設計や、制約と矛盾する設計が減る。「なぜUNIQUEなのか」の背景も設計判断の材料になる |
実装が進むたびにこの作業を回せば、DB定義書が実装と乖離せず、AIのコンテキストとして信頼できる状態を保てます。
次のページへ → 事例3:DB定義・用語集を元にAPI設計から実装まで進める
詳細情報
使用MCPツール・処理フロー・実測環境
使用したTRACERY MCPツール
#get_databases: DB定義書の全定義を取得。複数のDB定義がある場合の更新対象特定に利用#update_column: カラム定義(論理名・説明・概要)を更新。#update_database、#update_tableでDB・テーブル単位の更新も可能
処理フロー
        %%{init: {"theme": "neutral"}}%%
sequenceDiagram
  Actor User as 利用者
  participant Repo as ソースコード
  participant Agent as AIエージェント
  participant MCP as TRACERY MCP
  participant DB as DB定義書
  User->>Agent: 解析指示(プロンプト)
  Agent->>Repo: コード解析
  Repo-->>Agent: モデル定義・コメント
  Agent->>MCP: 既存DB定義の取得(参照)
  MCP->>DB: DB定義を取得
  DB-->>MCP: 既存定義
  MCP-->>Agent: 既存定義
  Agent-->>User: 論理名・説明の提案
  User->>Agent: 内容を確認して承認
  loop DB定義の更新
    Agent->>MCP: DB定義更新(保存)
    MCP->>DB: DB定義を更新
    DB-->>MCP: 更新完了
    MCP-->>Agent: 更新完了
  end
  Agent-->>User: 更新結果の報告
実測環境
対象データ: テーブル数12、カラム数約200
VSCode 1.109 / GitHub Copilot Agent / Claude Sonnet 4.6
TRACERY MCP
