事例1:ソースコードと議事録から用語集を整備する
課題:用語の定義が議事録に埋もれ、表記ゆれが放置される
ミーティングで用語の定義を合意したのに、議事録に埋もれて誰も用語集に反映しない。気づけばコードでは favorite、設計書では「ブックマーク」、会話では「お気に入り」──。
TRACERY MCPを使うと、AIエージェントがソースコード・DB定義・議事録から抽出した用語で、用語集を整備・更新し続けられます。
結果:ミーティング後の用語集更新が10分以内に
従来(手作業) |
MCP活用 |
|
|---|---|---|
作業時間 |
20〜50分 |
約8〜10分 |
内訳 |
議事録の読み返し10〜20分、用語の整理・登録10〜30分 |
AIが解析・更新3〜5分、人間の確認・承認5分 |
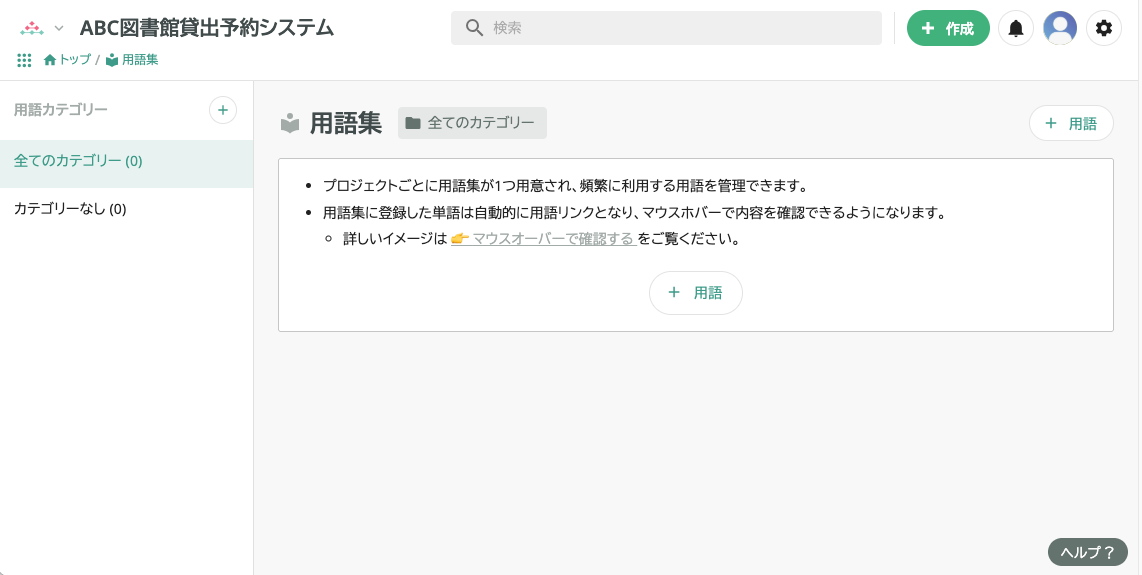
Before:未整備の用語集
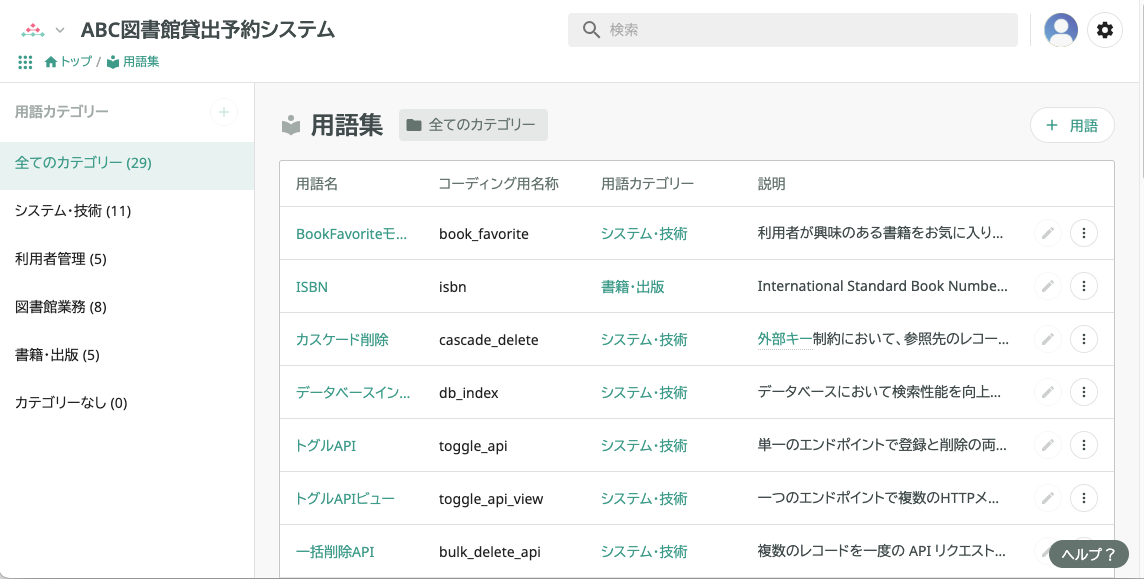
After:カテゴリー分けされ、コーディング用名称まで揃った用語集
やっていること
AIエージェントが既存用語をTRACERY MCP経由で取得し、情報源(ソースコード・DB定義・議事録)から抽出した用語候補と照合して、差分だけを登録・更新します。
        %%{init: {"theme": "neutral"}}%%
flowchart LR
    Src[ソースコード<br>DB定義・議事録] --> Agent[AIエージェント]
    Agent -->|既存用語と照合して差分登録| MCP[TRACERY MCP] --> Glossary[用語集]
    User((利用者)) -->|指示・確認| Agent
実際の手順
1. ソースコードから初期整備する
プロンプト例
DB定義とソースコードに基づいて、用語集に用語を登録してください。
- まず既存の用語集を確認してください。
- 対象ドメインの専門用語を優先し、カテゴリー分けして登録してください。
- コーディング用名称は小文字のスネークケースで定義してください。
- 既存の用語と重複する場合は更新してください。
AIが既存用語をMCP経由で取得・照合してから差分のみ登録するため、重複なく整備できます。
2. 議事録から継続的に更新する
定例ミーティングの議事録や文字起こしをAIに渡して、新規用語や定義の変更を反映させます。
プロンプト例
添付の議事録から、用語集に追加・更新すべき用語を抽出してください。
- 既存の用語集を確認し、重複や定義の変更がある場合は差分を教えてください。
- 新規用語は「図書館業務」カテゴリーに追加してください。
- コーディング用名称は小文字のスネークケースで定義してください。
AI応答例(イメージ)
議事録から3件の用語を抽出しました。
【新規】予約取り置き(
reservation_hold): 貸出中書籍の返却時に優先確保する仕組み【更新】お気に入り(
favorite): 上限が「無制限」→「100件」に変更されていました【既存と重複】ブックマーク → 「お気に入り」の同義語として追記します
#create_term / #update_term を実行してよろしいですか?
注釈
Google Workspaceの場合: Google Meetの文字起こしをNotebookLMに取り込み、用語をテーブル形式(用語・カテゴリー・コーディング用名称・説明)でCSV出力してから、AIエージェントに既存用語との照合と更新を指示する方法も有効です。
3. 差分を確認して反映する
AIが追加・変更する用語の一覧を提示するので、内容を確認して承認します。定義の解釈が曖昧な場合は修正を指示してください。
コツと注意点
コーディング用名称も一緒に定義させると、実装時の命名がぶれなくなります。
定義の解釈は人間が確認する。抽出の網羅性は高いですが、ニュアンスの判断はレビューが必要です。
整備した用語集は、事例3:API設計・実装などの後続タスクでAIが参照するコンテキストになり、不正確な用語の使用を防ぎます。
開発サイクルでの位置づけ
        %%{init: {"theme": "neutral"}}%%
flowchart LR
    A[事例1:用語集の整備]:::current --> C[事例3:API設計・実装]
    B[事例2:DB定義書の最新化] --> C
    C --> D[事例4:運用手順書の整備]
    D -.->|知見の還流| A
    D -.-> B
    classDef current fill:#4a6fa5,color:#fff,stroke:#4a6fa5
項目 |
内容 |
|---|---|
受け取るもの |
ソースコード・DB定義・議事録(情報源)。事例4(運用手順書)で見つかった新しい用語や定義変更も還流してくる |
この事例で作る資産 |
用語名・コーディング用名称・カテゴリー・説明が揃った用語集 |
次の事例への効き方 |
事例3のAPI設計でAIが用語集を参照するため、APIのフィールド名・エラーメッセージ・設計書の記述がチームの定義と揃う。表記ゆれ(favorite / ブックマーク / お気に入り)が設計段階で消える |
議事録からの継続更新を回すことで、用語集が「作って終わり」の死んだドキュメントにならず、AIのコンテキストとして生き続けます。
次のページへ → 事例2:ソースコードからDB定義書を最新化する
詳細情報
使用MCPツール・処理フロー・実測環境
使用したTRACERY MCPツール
#get_terms: 用語集の一覧を取得。登録前に既存用語を確認し、重複を避けるために使用#create_term: 新しい用語を登録。用語名・コーディング用名称・概要・説明・カテゴリーを設定可能#update_term: 既存の用語を更新。内容が古くなった用語の修正に使用
処理フロー
        %%{init: {"theme": "neutral"}}%%
sequenceDiagram
  Actor User as 利用者
  participant Source as 情報源
  participant Agent as AIエージェント
  participant MCP as TRACERY MCP
  participant Glossary as 用語集
  User->>Agent: 用語登録の指示(プロンプト)
  Agent->>Source: 情報源を参照
  Source-->>Agent: ソースコード・DB定義・議事録
  Agent->>MCP: 既存用語の取得(参照)
  MCP->>Glossary: 用語集を取得
  Glossary-->>MCP: 既存用語一覧
  MCP-->>Agent: 既存用語一覧
  Agent->>Agent: ソース解析・用語候補の抽出
  Agent-->>User: 追加・更新する用語の提案
  User->>Agent: 内容を確認して承認
  loop 用語の登録・更新
    Agent->>MCP: 用語の登録・更新(保存)
    MCP->>Glossary: 用語集を更新
    Glossary-->>MCP: 更新完了
    MCP-->>Agent: 更新完了
  end
  Agent-->>User: 登録結果の報告
実測環境
対象データ: プロジェクトのソースコード・DB定義(初期整備)、定例ミーティングの議事録(直近50ファイル規模の継続更新)
VSCode 1.109 / GitHub Copilot Agent / Claude Sonnet 4.6
Google NotebookLM(議事録からの用語抽出)
TRACERY MCP
